在人工智能从概念验证走向规模化商用的关键阶段,大模型已成为信息传输、软件和信息技术服务业的核心生产力工具。达个客大模型面向企业真实业务场景,提供从模型开发、行业训练到私有化部署与API接口对接的完整能力链路,帮助企业在数据安全可控的前提下,把AI能力真正嵌入业务流程。本文将从能力架构、落地路径、行业适配与选型要点四个维度展开,为正在评估企业级大模型方案的技术负责人提供一份可操作的参考。
一、企业为什么需要专属的大模型能力
通用大模型在开放域问答上表现亮眼,但一旦进入企业环境,往往会遇到三类现实问题:一是行业术语与内部知识覆盖不足,回答看似流畅却经不起业务校验;二是数据出域带来的合规风险,金融、政务、医疗等领域尤其敏感;三是推理成本与响应时延难以匹配高并发业务系统。专属大模型的价值,正是在于把通用能力与企业私域数据、行业规则和系统集成需求结合起来。
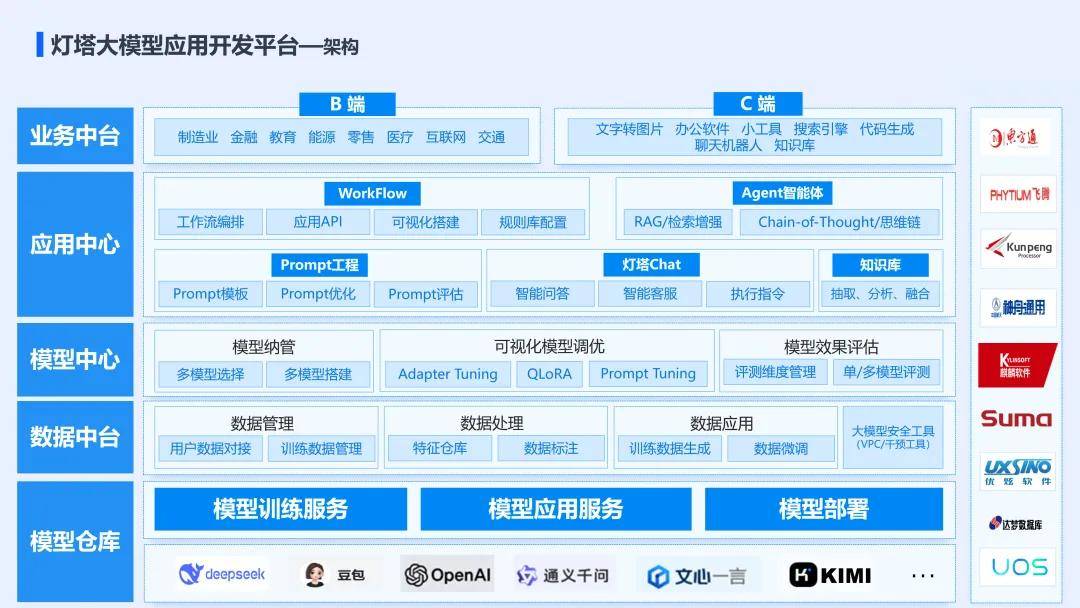
达个客大模型的定位并非单一模型产品,而是一套覆盖模型开发、AI模型定制、行业大模型训练、私有化部署与API接口的技术服务体系。它让企业既能借助成熟基座快速起步,又能通过持续训练把业务知识沉淀为可复用的模型资产。对于信息化基础较好、已有大数据与云计算平台的组织而言,这种"基座+定制"的路线通常比从零自研更具性价比。
二、达个客大模型的能力架构
1. 基座能力与模型开发工具链
达个客大模型提供经过中文语料深度优化的基座模型,并在模型开发环节配套数据清洗、指令微调、评测对齐等工具链。技术团队可以基于业务语料完成监督微调与偏好优化,再通过自动化评测集验证效果,避免"调完不知道好不好"的盲目迭代。工具链的价值在于把模型开发从少数算法专家的手工劳动,转变为可管理、可复现的工程流程。
2. 行业大模型训练与知识注入
行业大模型训练的关键不在算力堆叠,而在数据治理与知识组织。达个客大模型支持将企业文档、工单记录、产品手册、法规条文等非结构化数据转化为训练语料,并结合检索增强生成(RAG)技术构建企业知识库。对于知识更新频繁的场景,检索增强比全量重训更经济,也更便于追溯答案来源,这对需要审计留痕的行业尤为重要。
3. 智能问答系统与业务集成
智能问答系统是企业感知大模型价值最直接的入口。达个客大模型支持多轮对话、意图识别与工具调用,可对接工单系统、CRM、OA与客服平台,实现从"回答问题"到"办理业务"的延伸。例如在技术支持场景中,问答系统可先检索知识库给出解决方案,再自动创建工单并流转至对应工程师,形成闭环。
4. 大模型API接口与私有化部署
在交付形态上,达个客大模型同时提供云端API接口与私有化部署两种模式。API接口适合快速验证与轻量集成,按调用量计费、弹性扩缩;私有化部署则把模型、向量库与推理服务整体部署在企业自有服务器或专有云中,数据不出域,满足等保与行业监管要求。两种模式可组合使用,例如核心数据走私有化、边缘场景走API。
三、从试点到规模化:企业落地的四个阶段
- 场景筛选:优先选择高频、规则相对清晰、容错率可控的场景,如内部知识问答、客服辅助、文档摘要与代码辅助,避免一开始就切入高风险决策环节。
- 数据准备:梳理私域语料来源,建立数据分级与脱敏机制,明确哪些数据可用于训练、哪些仅用于检索,确保合规底线。
- 小范围验证:用真实业务样本构建评测集,量化准确率、召回率与人工接管率,以数据而非主观感受判断是否进入下一阶段。
- 规模推广与运维:建立模型版本管理、效果监控与反馈回流机制,把用户纠错转化为下一轮训练数据,形成持续优化的飞轮。
这一路径与系统集成、运维服务的传统方法论高度契合。大模型不是一次性交付的软件,而是需要持续运营的"活系统",运维监控、安全审计与效果评估应当从第一天就纳入设计。
四、行业适配:从桑日县人工智能实践看区域数字化
大模型的价值在不同区域、不同行业呈现出差异化形态。以桑日县人工智能相关实践为例,县域层面的数字化往往面临技术人才稀缺、IT预算有限、业务场景分散的现实约束。此时,轻量化的智能问答系统、可私有化部署的中等规模模型,以及标准化的API接口,比庞大的自研团队更具可行性。达个客大模型通过降低模型定制与部署门槛,让区域政府、事业单位与中小企业也能以较低成本获得可用的AI能力,用于政务服务咨询、政策解读、农牧业技术问答等场景。
在信息传输与软件服务行业内部,大模型同样在重塑服务形态:软件开发环节可用于代码生成与测试用例编写,系统集成环节可用于接口文档理解与故障排查,运维环节可用于日志分析与告警根因定位。这些场景的共同点是知识密集、重复性高,正是大模型擅长的领域。
五、选型要点:评估企业级大模型的六个维度
- 数据安全与合规:是否支持私有化部署、数据是否出域、是否具备审计日志与权限隔离能力。
- 定制深度:是否支持微调、检索增强与知识库更新,能否适配企业专有术语体系。
- 集成友好度:API接口是否规范、是否提供SDK与文档、能否与现有系统平滑对接。
- 成本结构:推理成本、训练成本与运维成本是否透明,是否支持按需弹性扩缩。
- 效果可验证:是否提供评测工具与基准数据,能否量化上线前后的业务指标变化。
- 服务能力:是否具备从咨询、开发到运维的完整技术服务链条,响应机制是否明确。
需要提醒的是,大模型选型不应只看参数规模与榜单分数。企业真正需要的是在自身业务语料上表现稳定、可解释、可维护的模型能力。一个在通用评测中排名靠前但无法私有化部署的模型,对数据敏感型企业而言未必是最优解。
六、结语:让大模型成为可运营的基础设施
达个客大模型所代表的,是一种务实的 enterprise AI 落地思路:以基座模型为起点,以行业训练与私有化部署为保障,以API接口与智能问答系统为触点,把大模型从演示Demo变成可运营的基础设施。对于信息传输、软件和信息技术服务业的企业来说,真正的竞争壁垒不在于是否用上了大模型,而在于能否把私域知识、业务流程与模型能力持续耦合,形成别人难以复制的数据与场景优势。选对路线、小步验证、持续运营,才是企业级大模型走向规模化价值的稳妥路径。